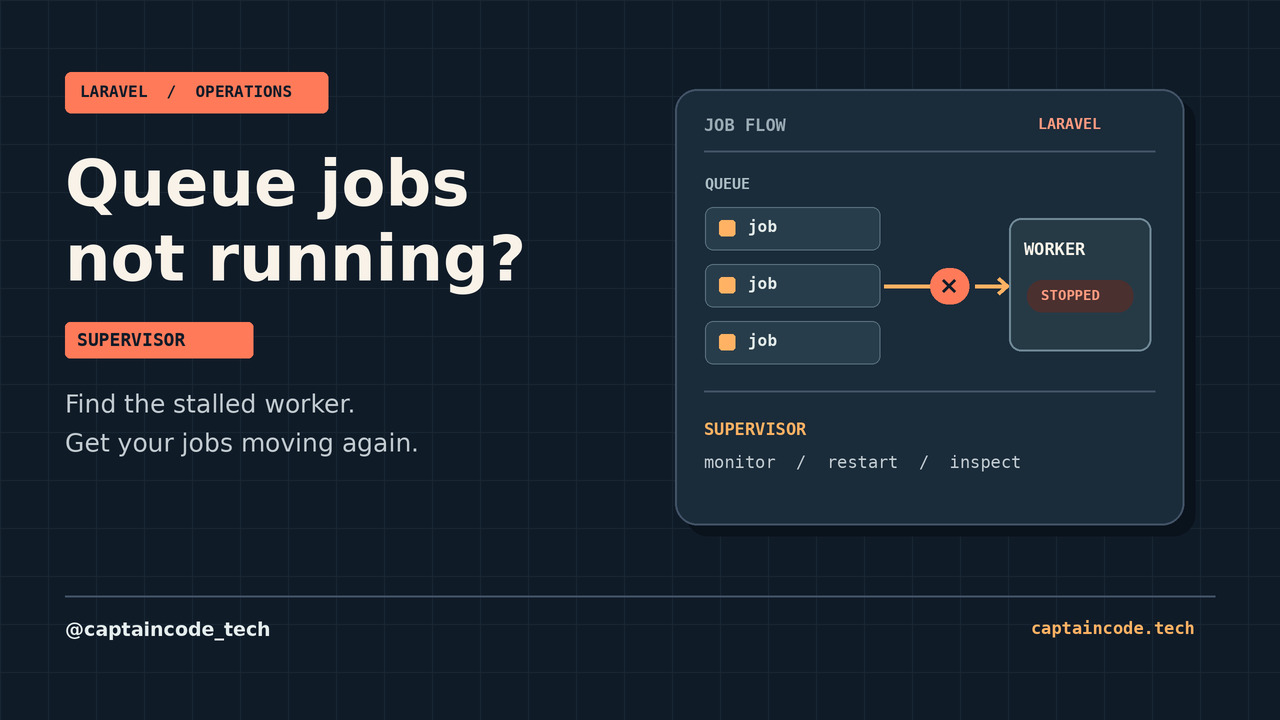
اگر صف لاراول با Supervisor پردازش نمیشود، اول وضعیت worker و تطابق connection و نام صف را بررسی کن؛ بعد سراغ دسترسی به backend، خطاهای job و تغییرات deploy برو.
این راهنما برای Laravel 12.x و سرور لینوکسی دارای Supervisor است. دستورها فرض میکنند اپراتور مجاز در پوشه نسخه منتشرشده برنامه است؛ مقادیر مثال را بدون بررسی روی سرور اعمال نکن.[1]
مشکل را از کجا پیدا کنیم؟
Connection تنظیمات اتصال به backend صف است و queue name نام صف در همان اتصال. هر job میتواند هر کدام را تغییر دهد. درایور sync کار را فوری اجرا میکند و به worker جداگانه منتظر نمیماند؛ درایور null هم job را کنار میگذارد.[1]
| نشانه | چه چیزی را بررسی کنیم؟ | اقدام بعدی |
|---|---|---|
| وضعیت Supervisor برابر BACKOFF، FATAL یا STOPPED است | لاگ Supervisor و worker، مسیر PHP، پوشه اجرا، مجوز کاربر و دسترسی backend | خطای واقعی راهاندازی را رفع کن و تغییر هدفمند بده |
| worker در وضعیت RUNNING است ولی job منتظر مانده | connection و صف مشخصشده در job را با دستور worker و config/queue.php مقایسه کن |
نامها را هماهنگ کن و تأخیر job و دسترسی backend را بررسی کن |
| job ناپدید شده ولی نتیجه مورد انتظار دیده نمیشود | ثبت failed job، لاگ برنامه و پاسخ سرویس مقصد | پیش از retry، علت همان خطا را پیدا کن |
| پس از deploy رفتار عوض شده | مسیر نسخه منتشرشده و restart شدن worker را بررسی کن | پس از تأیید deploy، worker را بهشکل graceful بازراهاندازی کن |
نام گروه را با نام واقعی سرورت جایگزین کن:
sudo supervisorctl status 'laravel-worker:*'
php artisan queue:failed
RUNNING فقط نشان میدهد process اجراست، نه اینکه صف درست را میخواند یا job موفق میشود. تنظیمات onConnection و onQueue خود job، دستور واقعی worker و کانفیگ مؤثر را بررسی کن. اطلاعات محرمانه را چاپ نکن. با config cache، فایل .env در درخواستها و دستورهای Artisan بارگذاری نمیشود؛ پس مقایسه env() خارج از فایلهای config گمراهکننده است.[2] برای جزئیات علت اعمال نشدن تغییرات env در لاراول را ببین.
تنظیم Supervisor برای صف موردنظر
این پیکربندی فقط نمونه است. مسیر PHP و نسخه برنامه، کاربر یونیکس، مسیر لاگ، connection و نام صفها را با مقادیر واقعی جایگزین کن. کاربر باید اجازه خواندن نسخه برنامه و نوشتن لاگ را داشته باشد و connection موردنظر در config/queue.php تعریف شده باشد.
[program:laravel-worker]
process_name=%(program_name)s_%(process_num)02d
directory=/srv/example/current
command=/usr/bin/php /srv/example/current/artisan queue:work redis --queue=emails,default --sleep=3 --tries=3 --timeout=60
autostart=true
autorestart=true
user=appworker
numprocs=1
redirect_stderr=true
stdout_logfile=/srv/example/shared/logs/queue-worker.log
stopwaitsecs=120
در این مثال redis نام connection و emails,default نام صفها به ترتیب اولویتاند. --tries=3 سقف تلاش worker را تعیین میکند، اما تنظیمات خود job میتوانند آن را تغییر دهند. autorestart جایگزینی worker خارجشده را ممکن میکند و stopwaitsecs باید از طولانیترین زمان مورد انتظار job بیشتر باشد. تعداد process و زمانها را متناسب با کار خودت تعیین کن.[1]
در این نمونه مقدار مؤثر retry_after اتصال Redis باید چند ثانیه از timeout worker بیشتر باشد و timeout اختصاصی job هم در محاسبه دیده شود. SQS بهجای آن از visibility timeout استفاده میکند. مقادیر نمونه فقط وقتی مناسباند که با زمان واقعی job و تنظیمات backend سازگار باشند؛ در غیر این صورت آنها را با هم تنظیم کن. اجرای تکراری ممکن است، پس تا جای ممکن اثرات جانبی job را idempotent طراحی کن.[1]
پس از بررسی تغییرات و انتخاب زمان مناسب، اپراتور مجاز میتواند پیکربندی را بارگذاری کند:
sudo supervisorctl reread
sudo supervisorctl update
sudo supervisorctl status 'laravel-worker:*'
دستور update ممکن است گروههای تغییرکرده دیگر Supervisor را هم تحت تأثیر قرار دهد؛ قبل از اجرا همه تغییرات معلق را بررسی کن. اگر گروه بالا نیامد لاگ worker را بخوان. در پایان یک job آزمایشی مجاز و بدون اثر مخرب اجرا کن و نتیجه را در backend و برنامه بررسی کن؛ به وضعیت process اکتفا نکن.
Deploy و jobهای ناموفق
Worker طولانیعمر تغییر کد را خودکار بارگذاری نمیکند. بعد از تأیید deploy، از پوشه نسخه موردنظر دستور زیر را اجرا کن؛ worker پس از پایان job جاری خارج میشود و process manager پیکربندیشده میتواند جایگزینش کند.[1]
php artisan queue:restart
سیگنال از cache برنامه استفاده میکند؛ دستور و workerهای موردنظر باید به cache تنظیمشده یکسان دسترسی داشته باشند. process جدید و مسیر نسخه را بررسی کن. اگر worker واکنش نداد، دسترسی cache و غیرفعال نبودن polling سیگنال restart را بررسی کن؛ تصور نکن reload کردن PHP-FPM یا reset کردن OPcache از CLI، worker صف را restart میکند.[1] برای تصویر کاملتر، دیپلوی خودکار با GitHub Actions را ببین.
دستور queue:failed خطاهای ثبتشده را در صورت پشتیبانی provider تنظیمشده نشان میدهد. ذخیره خطا ممکن است غیرفعال یا در backend دیگری باشد؛ خالی بودن فهرست اثبات موفقیت نیست.[1] لاگ محافظتشده و علت خطا را بدون افشای payload یا اطلاعات محرمانه بررسی کن. Retry ممکن است پرداخت یا ایمیل را تکرار کند؛ اول علت را رفع کن، بیخطر و idempotent بودن job را تأیید کن و مجوز بگیر. اگر امن بود، شناسه دقیق خروجی queue:failed را جایگزین کن:
php artisan queue:retry <failed-job-id>
علامتهای زاویهای را واقعاً تایپ نکن. Retry گروهی و حذف داده را میانبر عیبیابی قرار نده.
امنیت و بررسی نهایی
Worker را با کاربر اختصاصی و حداقل دسترسی اجرا کن؛ دسترسی به کنترل Supervisor، لاگها، اطلاعات مشتری و credentialها را محدود کن و نگهداری لاگ را طبق سیاست سازمان تنظیم کن. دسترسی backend، تطابق connection و صف، مسیر نسخه worker، timeoutها و نتیجه job آزمایشی مجاز را بررسی کن. درباره مجوزهای مرتبط با deploy، رفع خطای storage link و Nginx را هم بخوان.
سوالات متداول
آیا وضعیت RUNNING در Supervisor یعنی job درست کار میکند؟
خیر. این وضعیت فقط اجرای process را نشان میدهد، نه مصرف صف درست یا موفقیت job. با job آزمایشی امن و لاگها نتیجه را بررسی کن.
آیا connection همان نام صف است؟
خیر. Connection backend تنظیمشده را مشخص میکند و هر اتصال میتواند چند صف نامگذاریشده داشته باشد.[1] تنظیمات اختصاصی job و گزینههای worker را با هم بررسی کن.
چرا worker بعد از deploy کد قدیمی اجرا میکند؟
queue:work طولانیعمر است و تا restart نشود تغییر کد را تشخیص نمیدهد.[1] فرآیند restart مربوط به deploy را اجرا کن و process جدید و مسیر نسخه را بررسی کن.
آیا همه failed jobها را retry کنم؟
خیر. ابتدا خطا و اثرات جانبی را بررسی کن؛ retry ممکن است عملیات بیرونی را تکرار کند. فقط job مشخص و مجاز را پس از اطمینان از امن بودن دوباره اجرا کن.
آیا Horizon جایگزین این تنظیم worker است؟
Horizon صفهای Redis را مدیریت میکند و dashboard دارد، اما process خود horizon نیز در production به process manager برای نظارت نیاز دارد.[3] بهجای کپی این مثال، راهنمای deploy خود Horizon را دنبال کن.
جمعبندی
Backend و صف واقعی را شناسایی کن، سلامت worker و خطاها را بررسی کن و تا موفقیت یک job آزمایشی امن، مشکل را حلشده حساب نکن. اگر برای عیبیابی deploy لاراول کمک میخواهی، با تیم کاپیتان کد تماس بگیر.
Sources
[1] https://laravel.com/docs/12.x/queues [2] https://laravel.com/docs/12.x/configuration [3] https://laravel.com/docs/12.x/horizon