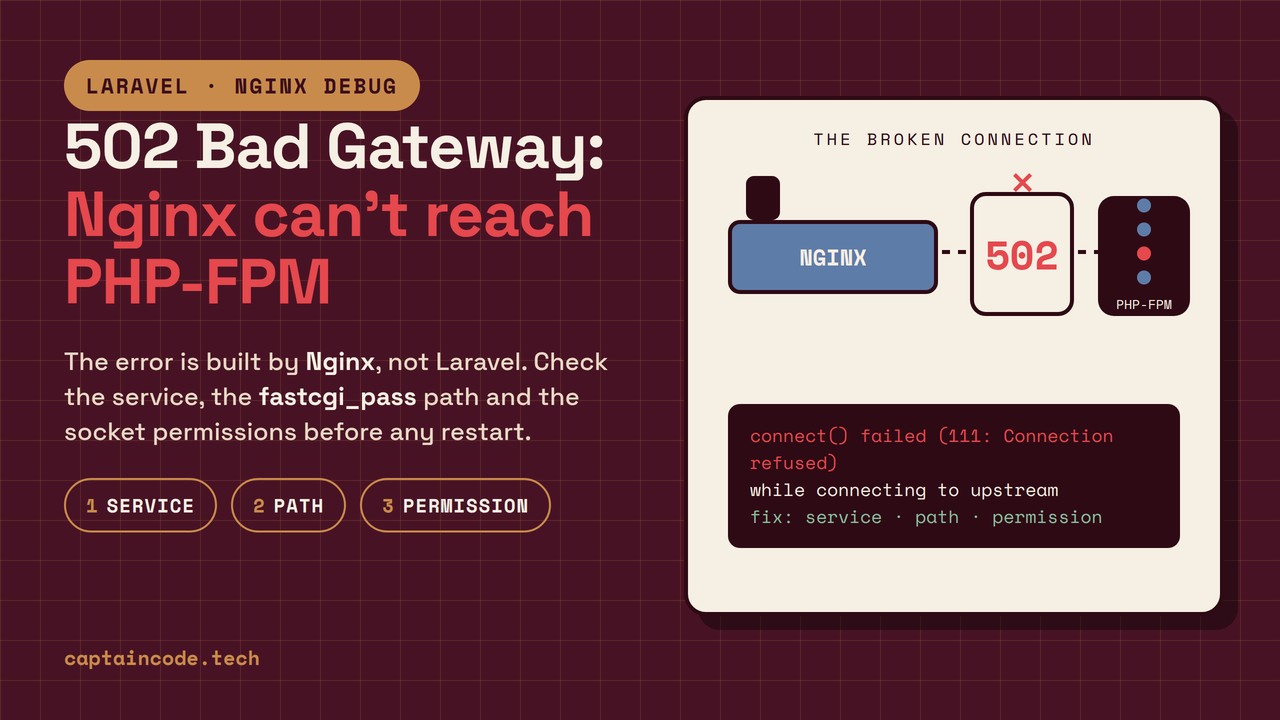
خطای 502 Bad Gateway یعنی Nginx نتونست به PHP-FPM وصل بشه یا ازش جواب معتبر نگرفت؛ این خطا رو Nginx تولید میکنه، نه لاراول. برای همین اگه 502 میبینی و storage/logs/laravel.log خالیه، یعنی درخواست اصلاً به PHP نرسیده و باید لاگ خطای Nginx رو بخونی. قبل از هر systemctl restart بیدلیل، سه چیز رو با همین ترتیب چک کن: (۱) سرویس PHP-FPM زندهست؟ (۲) مسیر socket یا پورت TCP که تو fastcgi_pass نوشتی واقعاً وجود داره؟ (۳) مالک و سطح دسترسی فایل socket درسته؟ تو این مقاله میبینی مشکل دقیقاً کجای مسیره، کدوم لاگ رو بخونی و کدوم دستور رو بزنی، و یه نکتهی مهم دیگه: بعضی وقتا چیزی که فکر میکنی 502 ـه، در واقع 504 Gateway Timeout ـه و علتش فرق داره.
خطای 502 دقیقاً چیه و از کجا میاد؟
وقتی Nginx یه درخواست PHP رو از طریق fastcgi_pass به FPM میده، سه چیز ممکنه خراب بشه: وصل شدن، خوندن هدر جواب، و رسیدن جواب تو زمان مجاز. رفتار Nginx تو هر سه حالت فرق داره:
| چیزی که تو لاگ Nginx میبینی | یعنی چی | معمولاً با کدوم خطا |
|---|---|---|
connect() failed (111: Connection refused) while connecting to upstream |
FPM خاموشه یا مسیر/پورت fastcgi_pass اشتباهه |
502 |
connect() failed (13: Permission denied) while connecting to upstream |
Nginx اجازهی باز کردن socket رو نداره | 502 |
upstream sent too big header |
هدر جواب از اندازهی fastcgi_buffer_size بزرگتره |
502 |
recv() failed (104: Connection reset by peer) |
FPM وسط جواب دادن ریاستارت شده | 502 |
no live upstreams while connecting to upstream |
بلوک upstream خالیه یا همهی سرورهاش fail شدن |
502 |
upstream timed out (110: Connection timed out) |
جواب تو زمان مجاز نیومده | معمولاً 504 |
تفکیک 502 و 504 از خود سورس Nginx درمیاد: خطای timeout به NGX_HTTP_GATEWAY_TIME_OUT (همون 504) میرسه و بقیهی خطاها به NGX_HTTP_BAD_GATEWAY (همون 502) (سورس ngx_http_upstream.c). نتیجهی عملی: اگه سایت خیلی دیر جواب میده و بعدش خطا میده، دنبال timeout بگرد؛ اگه فوری خطا میده، دنبال مشکل اتصال.
چرا تو پروژههای لاراولی این خطا بیشتر پیش میاد؟
لاراول تو 502 هیچ نقشی نداره؛ مشکل لایهی Nginx ↔ PHP-FPM ـه. ولی سه رفتار رایج پروژههای لاراولی احتمالش رو بالا میبره:
- هدرهای جواب بزرگ: با Livewire یا Inertia و کوکیهای زیاد، هدر جواب ممکنه از اندازهی پیشفرض
fastcgi_buffer_size(که توی مستندات Nginx مقدار4k|8kـه) بزرگتر بشه وupstream sent too big headerببینی. - worker pool کم میاد: کوئریهای کند یا صفهای سنگین میتونن FPM رو تا سقف
pm.max_childrenمشغول کنن؛ بعدش درخواستهای جدید یا timeout میخورن یا جواب نمیگیرن. برای همین هر چی مالکیت و فیکس worker رو بهبود بدی، رو نرخ خطا اثر مستقیم داره. - عملیات روی production: اجرای
composer installیا migration با کاربر root میتونه مالکیت فایلها و socket رو عوض کنه و Nginx دیگه نتونه وصل بشه.
اگه صف و Supervisor رو هنوز تنظیم نکردی، اول مقالهی رفع مشکل صف لاراول با Supervisor رو بخون؛ worker های گیرکرده یهی از خطرناکترین بارهای روی FPM هستن.
اول بفهم رو کدوم سکویی هستی
مسیر درخواست تو هر محیط فرق داره و همین علت اصلی گیر کردن تو عیبیابیه:
| سکو | PHP چطور صدا میشه | 502 معمولاً از کجا میاد |
|---|---|---|
| VPS با Nginx + FPM | fastcgi_pass unix:/run/php/php8.3-fpm.sock یا fastcgi_pass 127.0.0.1:9000 |
مسیر socket اشتباه (مخصوصاً بعد از آپدیت PHP)، دسترسی، FPM خاموش |
| cPanel / DirectAdmin | FPM رو خود پنل مدیریت میکنه و هر کاربر pool خودش رو داره | تنظیمات pool رو مستقیم نمیتونی عوض کنی؛ باید از بخش مدیریت PHP پنل یا پشتیبانی هاست پیگیری کنی |
| Docker | fastcgi_pass app:9000 (TCP بین کانتینرها) |
اسم service تو docker-compose.yml اشتباهه، یا کانتینر FPM تو restart loop ـه |
روی VPS، مسیر کلی اینه:
Browser → Nginx (:80/:443)
├─ فایلهای استاتیک از public/ رو خودش سرو میکنه
└─ بقیهی درخواستها → fastcgi_pass unix:/run/php/php8.3-fpm.sock
→ pool ی FPM (تا سقف pm.max_children)
→ Laravel (public/index.php) → جواب به Nginx → مرورگر
دو نکته از خود سورس PHP: توی فایل www.conf.in ی php-src، پیشفرض listen مقدار 127.0.0.1:9000 ـه و listen.mode پیشنهادی 0660 ـه؛ ولی بستههای Ubuntu معمولاً یه unix socket مثل /run/php/php8.3-fpm.sock ست میکنن. یعنی چیزی که تو سرورت واقعاً تنظیمه رو باید از کانفیگ pool خودت بخونی، نه از حدس.
مرحله ۱: تشخیص بدون restart
این دستورات چیزی رو تغییر نمیدن؛ فقط میخوان بفهمی دقیقاً کجای مسیر شکسته:
# ۱. وضعیت سرویس PHP-FPM (نسخهی PHP رو با خودت عوض کن)
sudo systemctl status php8.3-fpm --no-pager
# ۲. آیا اصلاً socket هست؟
ls -la /run/php/
# ۳. مالک و دسترسی socket
stat /run/php/php8.3-fpm.sock
# ۴. Nginx به کجا اشاره میکنه؟ (nginx -T همهی کانفیگهای include شده رو میبینه)
sudo nginx -T 2>/dev/null | grep fastcgi_pass
# ۵. آخرین خطاها
sudo tail -n 50 /var/log/nginx/error.log
چطور خروجی رو تفسیر کنی:
systemctl status: اگهactive (running)دیدی، مشکل از سرویس نیست و برو سراغ socket و دسترسی. اگهinactive (dead)یاfailedدیدی،journalctl -xeu php8.3-fpm --no-pagerرو بزن؛ معمولاً یه syntax error تو کانفیگ pool پیداش میکنه.ls /run/php/: اگه فایل socket نیس، یعنی سرویس هنوز شروع نشده یاlistenتوی کانفیگ pool جای دیگهای رو نشون میده. دقت کن مسیری کهnginx -Tنشون میده با مسیر واقعی فایل یکی باشه؛ ناهماهنگی این دو، رایجترین علت 502 بعد از آپدیت PHP ـه. ضمناًnginx -Tفقط برای fastcgi نیست؛ مشکلات دیگهی کانفیگ Nginx رو هم با همون رو پیدا میکنی، مثل خطای 404 لینک storage لاراول در Nginx.stat: نمونهی خروجی سالم توی اوبونتو چیزی شبیهAccess: (0660) Uid: ( 33/www-data) Gid: ( 33/www-data)ـه؛ اگه group با کاربرِ worker ی Nginx یکی نیست، همون خطایPermission deniedرو میبینی.- یه تست مستقیم دیگه، بدون Nginx: با ابزار
cgi-fcgi(روی اوبونتو تو بستهیlibfcgi-bin) یه اتصال تمیز به خود FPM باز کن:
sudo cgi-fcgi -bind -connect /run/php/php8.3-fpm.sock || echo "SOCKET FAIL"
sudo cgi-fcgi -bind -connect 127.0.0.1:9000 || echo "TCP FAIL"
اگه SOCKET FAIL یا TCP FAIL چاپ شد، مشکل تو خود FPM ـه، نه تو کانفیگ Nginx؛ قبل از هر تغییری لاگ FPM و journalctl رو بخون.
مرحله ۲: رفع سریع (وقتی الان downtime داری)
قانون این مرحله: باید بدونی چرا restart میکنی. هر restart بیدلیل، درخواستهای فعال رو قطع میکنه.
۲.۱ اگه FPM خاموشه
sudo systemctl start php8.3-fpm
sudo systemctl enable php8.3-fpm
اگه start نشد، خروجی journalctl -xeu php8.3-fpm --no-pager رو برای syntax error بخون، فیکس کن و دوباره start کن.
۲.۲ اگه Permission denied میبینی
بذار Nginx به socket برسه. دو راه داری: یا کاربر worker ی Nginx رو به گروه مالک socket اضافه کن، یا توی کانفیگ pool مالک socket رو تنظیم کن:
# /etc/php/8.3/fpm/pool.d/www.conf
listen.owner = www-data
listen.group = www-data
listen.mode = 0660
و بعد:
sudo systemctl reload php8.3-fpm
نکتهی مهم: reload کانفیگ رو دوباره میخونه و برخلاف restart، کار درخواستهای در حال پردازش رو به هم نمیزنه. برای بیشتر فیکسها reload کافیه.
۲.۳ اگه بعد از آپدیت PHP همهی سایتها 502 شدن
بعد از ارتقا از PHP 8.2 به 8.3، مسیر socket از php8.2-fpm.sock به php8.3-fpm.sock عوض میشه ولی کانفیگ Nginx هنوز به مسیر قدیم اشاره میکنه:
# مسیر فعلی socket ها
ls /run/php/

# کانفیگ رو اصلاح کن و قبل از reload حتماً تست بگیر
sudo sed -i 's|php8.2-fpm.sock|php8.3-fpm.sock|g' /etc/nginx/sites-enabled/*
sudo nginx -t && sudo nginx -s reload
همیشه اول nginx -t رو بزن؛ اگه syntax error باشه reload رد میشه و کانفیگ قدیمی سر جاش میمونه و سایت قطع نمیمونه.
مرحله ۳: ریشهای، وقتی 502 برمیگرده
اگه فیکس سریع جواب داد ولی بعد از یه مدت دوباره 502 دیدی، یه علت ساختاری داری. سه تا از رایجترینهاش:
۳.۱ tuning ی pm.* ی pool
پیشفرضهای www.conf ی php-src pm = dynamic، pm.max_children = 5، pm.start_servers = 2، pm.min_spare_servers = 1، pm.max_spare_servers = 3 و pm.max_requests = 0 هستن؛ یعنی pool کوچیک و بدون recycle ی worker. برای یه سایت لاراولی، این مقادیر رو بر اساس رم سرورت بالا ببر. بهعنوان مثال فرضی (نه نسخهی آماده): سرور ۴ گیگ رم، حدود ۲ گیگ برای PHP، با فرض ۵۰ مگابایت مصرف هر درخواست، یعنی pm.max_children حدود ۴۰؛ و یه فاصلهی احتیاطی هم نگه دار:
# فقط مثال؛ اعداد رو بر اساس رم واقعی سرور خودت بذار
pm = dynamic
pm.max_children = 40
pm.start_servers = 10
pm.min_spare_servers = 5
pm.max_spare_servers = 20
pm.max_requests = 500
pm.max_requests هر worker رو بعد از n درخواست recycle میکنه که مسیر نشت حافظهی کتابخانهها رو جمع میکنه. یادت باشه تغییر این فایلها خودش اعمال نمیشه؛ باید systemctl reload php8.3-fpm بزنی تا master process کانفیگ رو دوباره بخونه.
۳.۲ اندازهی بافر ی هدر تو Nginx
مطابق مستندات Nginx، پیشفرض fastcgi_buffer_size 4k|8k و fastcgi_buffers 8 4k|8k ـه (واحد 4k یا 8k به اندازهی صفحهی سیستمعامل وابستهست). هدرهای جواب لاراول (مخصوصاً با Inertia) ممکنه از این بزرگتر بشن:
# تو بلوک http یا server یا location
fastcgi_buffers 16 16k;
fastcgi_buffer_size 32k;
این مقادیر رو متناسب با هدرهای واقعی جوابهات تنظیم کن، نه بیدلیل حداکثری.
۳.۳ OPcache بعد از deploy
از سورس php-src، پیشفرضهای OPcache اینهاست: opcache.enable = 1، opcache.validate_timestamps = 1 و opcache.revalidate_freq = 2. یعنی بهطور پیشفرض فایلها هر ۲ ثانیه چک میشن و بعد از deploy بالاخره کد جدید لود میشه. ولی اگه جایی opcache.validate_timestamps = 0 گذاشته باشی، PHP تا reload بعدی کد قدیمی رو از حافظه سرو میکنه؛ نتیجهش رفتارهای عجیب بعد از هر دیپلویه. برای دیپلویهای پیوسته، بعد از هر deploy یه systemctl reload php8.3-fpm بزن تا مطمئن باشی کد جدید سرو میشه.
۳.۴ چطور دفعهی بعد زودتر بفهمی؟
از Laravel 11 به بعد یه مسیر سلامت داخلی به اسم /up داری (مستندات Deployment ی لاراول): اگه اپ بدون exception بالا اومده باشه 200 میده و در غیر این صورت 500. میتونی یه چک سادهی هر یک دقیقه ست کنی که اگه جواب سالم نیومد، بهت خبر بده:
# در crontab؛ هر یک دقیقه
* * * * * curl -fsS http://localhost/up >/dev/null || echo "502 ALERT: site down"
یادت باشه این خط باید از طریق crontab سرور بهموقع اجرا بشه؛ بعد از ست کردنش هم چند دقیقه خروجی رو چک کن که واقعاً درست کار میکنه.
جدول مرجع سریع: هر خطا، یک کار
| خطای Nginx | معنی | کار اصلی |
|---|---|---|
Connection refused |
FPM خاموش یا مسیر اشتباه | systemctl status php8.3-fpm و ls /run/php/ |
Permission denied |
مالکیت socket | تنظیم listen.owner/group تو pool و reload |
upstream sent too big header |
هدر بزرگتر از بافر | بالا بردن fastcgi_buffer_size و fastcgi_buffers |
Connection reset by peer |
FPM وسط کار ریاستارت شده | لاگ FPM و journalctl رو چک کن |
no live upstreams |
upstream خالی یا همه fail | بلوک upstream و fastcgi_pass رو بررسی کن |
upstream timed out |
جواب دیر رسید (معمولاً 504) | کوئریهای کند و ظرفیت pool رو مدیریت کن |
کی واقعاً به restart کامل نیاز داره؟
reload برای بیشتر فیکسها کافیه. restart کامل معمولاً وقتی لازمه که:
- توی
php.iniیه تغییر ساختاری دادی (مثلmemory_limit). - یه extension ی PHP جدید نصب کردی.
- تنظیم OPcache رو کامل عوض کردی.
و هیچوقت به پروسههای FPM kill -9 نزن؛ این کار درخواستهای فعال رو وسط کار قطع میکنه و ممکنه وضعیت سرویس رو بدتر کنه. کد اصلی تغییرات پیدرپی رو هم روی production قبلش یه جایی مثل staging امتحان کن؛ برای خطاهای رایج بعد از دیپلوی، مقالهی رفع خطای Vite manifest در production رو ببین.
سوالات متداول
۱. فرق 502 و 504 چیه؟
502 یعنی Nginx نونست وصل بشه یا جواب معتبر نگرفت؛ 504 یعنی وصل شده ولی جواب تو زمان مجاز (fastcgi_read_timeout، پیشفرض ۶۰ ثانیه) نرسید. اگه سایت قبل از خطا چند ثانیه معطلی داره، احتمالاً 504 ـه و سراغ timeout و کندی کد برو.
۲. چرا storage/logs/laravel.log خالیه ولی سایت 502 میده؟
چون 502 قبل از رسیدن به PHP اتفاق میافته؛ خطا تو لایهی اتصال Nginx به FPM ـه. لاگ خطای Nginx (/var/log/nginx/error.log) رو بخون؛ الگوی connect() failed یا upstream sent too big header همونجاست.
۳. چطور بفهمم PHP-FPM با socket کار میکنه یا TCP؟
توی کانفیگ pool (مثل /etc/php/8.3/fpm/pool.d/www.conf) دنبال listen بگرد. اگه با unix: شروع بشه، socket ـه؛ اگه 127.0.0.1:9000 باشه، TCP ـه. پیشفرض خود php-src مقدار TCP ـه و بستههای Ubuntu معمولاً socket میذارن.
۴. بعد از آپدیت PHP، همهی سایتهام 502 شدن. چیکار کنم؟
تقریباً همیشه یعنی مسیر socket تو کانفیگ Nginx قدیمیه. با ls /run/php/ مسیر جدید رو پیدا کن، fastcgi_pass رو اصلاح کن و بعد nginx -t و nginx -s reload.
۵. تغییر pm.max_children بدون reload اعمال میشه؟
نه. این تنظیم تو فایل pool نوشته میشه ولی تا وقتی FPM کانفیگ رو دوباره نخونه، بیاثره. systemctl reload php8.3-fpm بزن؛ reload برخلاف restart درخواستهای فعال رو قطع نمیکنه.
۶. مسیر /up چیه و چی کار به 502 داره؟
از Laravel 11 به بعد، یه مسیر سلامت داخلی هست که اگه اپ بدون exception بالا اومده باشه 200 و در غیر این صورت 500 میده. اگه /up خطا بده ولی بقیهی مسیرها 502 بدن، یعنی مشکل تو اتصال Nginx به FPM ـه نه تو یه route خاص.
جمعبندی
502 رو Nginx میسازه، نه لاراول؛ ترتیب چک هم همیشه یکیست: سرویس PHP-FPM، مسیر و نوع اتصال تو fastcgi_pass، مالکیت و دسترسی socket، بعد اندازهی بافر و ظرفیت pool. با این ترتیب، بیشتر موارد رو بدون restart تصادفی حل میکنی. اگه دنبال دیباگ سریعتری، Nyx رو امتحان کن؛ و اگه یه پروژهی لاراولی داری که عیبیابیش سنگین شده، از صفحهی تماس کاپیتان کد بهمون بگو.